小红书合作机会筛选与跟进
搜小红书接单需求,去重后按预算和 AI 接受度筛选,每条判断都带原帖证据
试试这样做
帮我搜一批小红书上的剪辑外包需求,去重后再按预算和 AI 接受度筛一遍。
我判断完了,把已经联系和需求确认的分开记下来,再导出成 CSV 给我。
重新搜一次上次的关键词,看看有哪些新线索,别和正在跟进的那几条重复。
详细介绍
小红书合作机会筛选与跟进
把小红书上的潜在线索整理成每条判断都能追溯到原帖证据、可跨天跟进、重新搜索不会重复的本地记录。与小红书无官方关联,只做读取、整理和本地记录。
能做什么
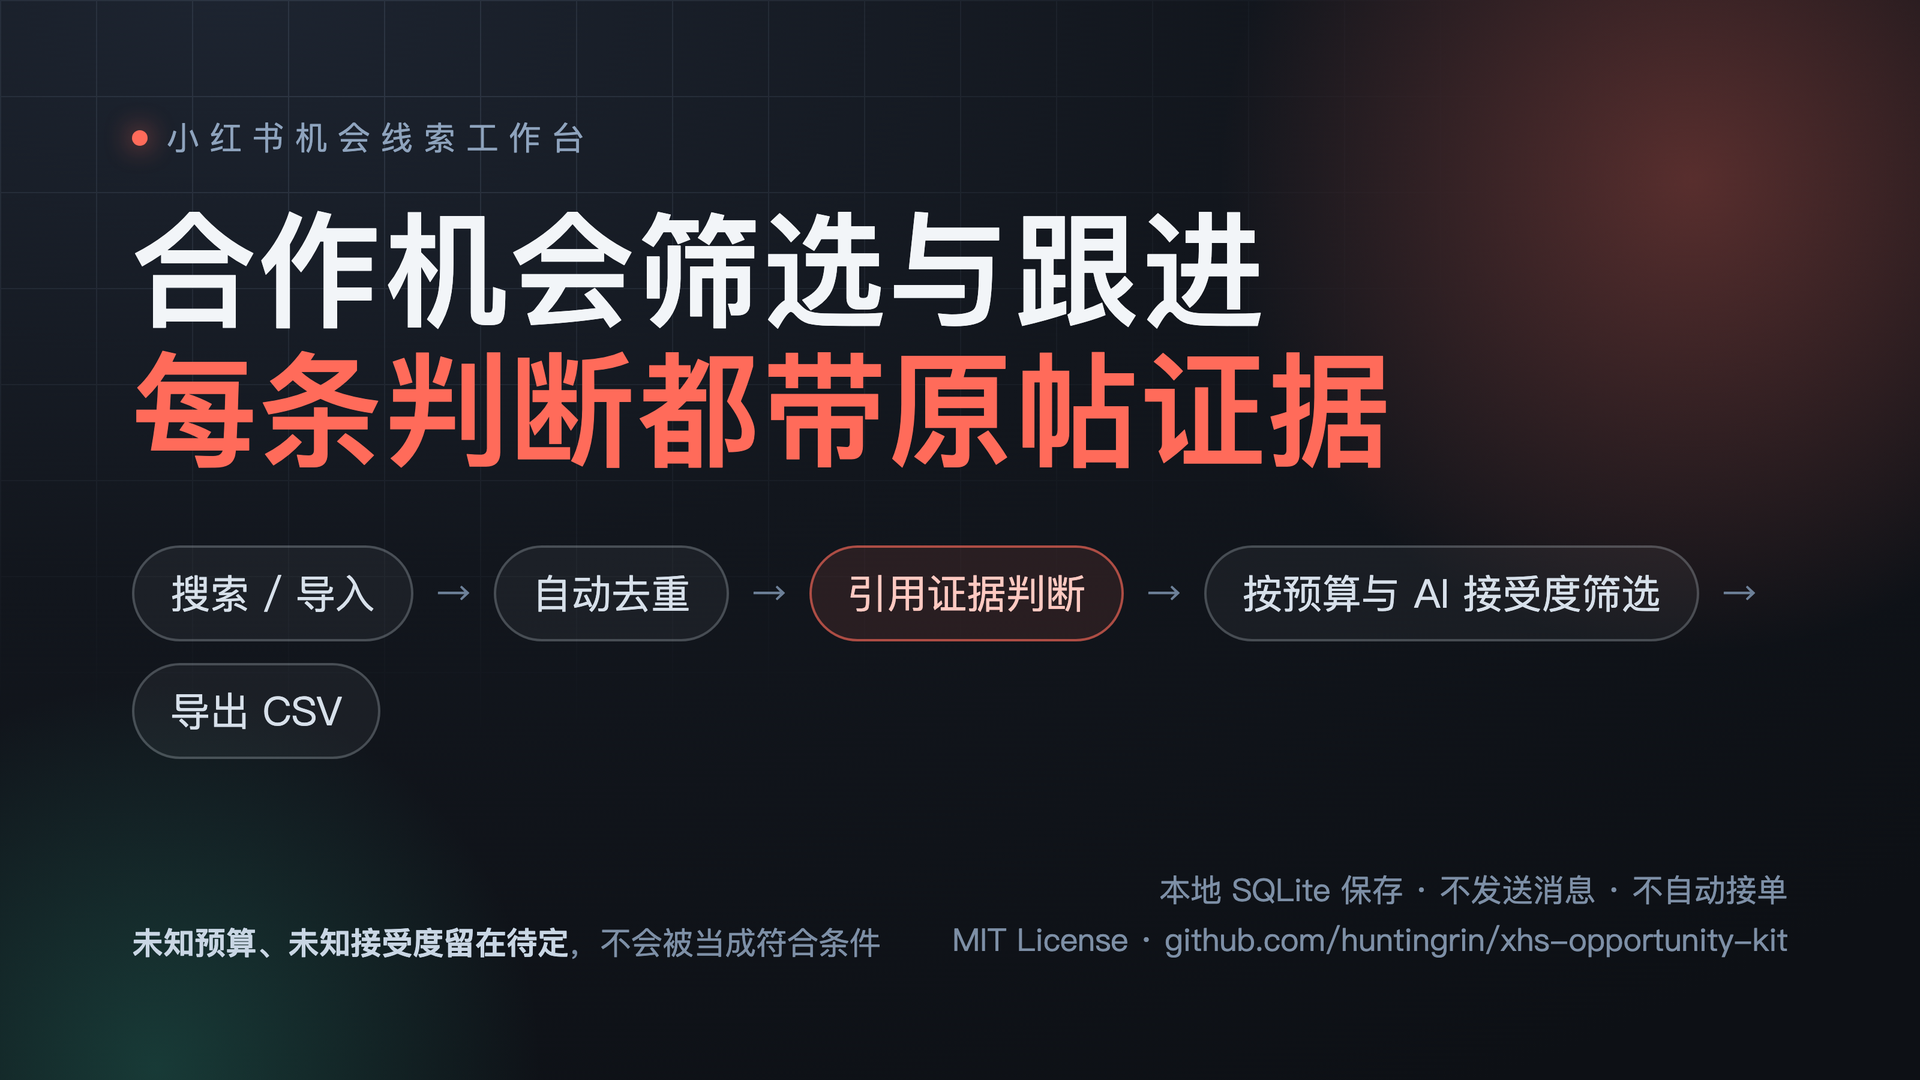
- 读取或导入:平台搜索结果、详情页正文与评论、以及你手里已有的线索表,都归到同一套记录里;从旧线索表导入时,旧结论会存成历史证据并进入待复核,不会被当成当前有效客户。
- 去重:同一条笔记反复出现不会重复入库,搜索卡片不会覆盖已经读到的详情,重跑同一批关键词也不会重复新增。
- 证据留痕:正文和评论都保存为带 ID 的证据。给线索下结论时必须引用证据 ID,引用不属于这条线索的证据会被直接拒绝。
- 判断与筛选:区分需求方与接单广告,按预算、是否接受 AI、时间范围给出「符合 / 待定 / 排除」和原因码。未知的预算或接受度留在待定,不会被当成符合。
- 跟进阶段:记录已联系、需求确认、已接受、已交付、已关闭;跳阶段会被拒绝,重复标记同一阶段是幂等的。
- 导出:CSV 或 JSON,并且不会覆盖已经存在的文件。
取数方式
| 你的环境 | 怎么取数 |
|---|---|
| 已经配好小红书连接 | 直接搜索并读取详情,自动保存正文与评论 |
| Agent 自己能读小红书 | 由 Agent 读页面,把内容规范成笔记数据后导入(不需要重新解决登录) |
| 什么都没有 | 导入、判断、筛选、导出依然全部可用,只有真实搜索需要平台连接 |
搜索覆盖范围没有保证:正常跑完也可能是「部分完成」,并保留覆盖范围未知的提示。部分完成不等于搜完了,结果和警告会一起返回。
一条线索的走向
- 读取或导入后,它出现在待处理列表里,带着原帖链接和证据。
- 读它的证据,再下判断:结论、理由、需求类型(需求方 / 供应方)、是否接受 AI、预算。
- 规则筛选给出符合、待定或排除,并说明原因。
- 按已联系、需求确认等阶段记录已经发生的事实。
- 需要对外交付时导出 CSV 或 JSON。
原帖内容更新后,旧判断会被标记为过期,规则筛选不会继续使用过期判断。
输出长什么样
"key","title","url","published_at","observed_at","stage","decision","review_stale","reason","ai_acceptance","budget","currency"
"xiaohongshu:synthetic-edit-001","示例:短视频剪辑需求","https://www.xiaohongshu.com/explore/synthetic-edit-001","2026-10-01T00:00:00Z","2026-10-01T10:00:00Z","discovered","priority","false","合成示例正文明确需要剪辑、接受 AI、预算 800 元。","accepted","800","CNY"
"xiaohongshu:synthetic-edit-002","示例:剪辑项目,预算待沟通","https://www.xiaohongshu.com/explore/synthetic-edit-002","","2026-10-01T10:00:00Z","discovered","unreviewed","false","","unknown","",""
上表是仓库示例数据的真实输出。每一行都可以回落到它引用的证据,而不是只留一个结论。
边界
- 不发送私信、不发布内容、不自动接单、不创建定时任务。
- 不替代浏览器和登录状态:需要登录、验证码时由你本人处理,不绕过验证。
- 不提供 OCR 和 LLM:截图里的文字需要由宿主识别后作为证据导入。
- 只保存规范化字段:不保存原始响应里的 Cookie、访问令牌或带签名链接。
数据与隐私
记录默认保存在操作系统的用户数据目录,不会写进技能目录或分享包;可以指定自己的数据库路径,一份数据库对应一个账号或工作区。正文、作者和评论仍可能包含个人信息,属于你的本地数据,导出前请按使用场景自行审阅。示例、测试与发布包都不含真实账户、线索或运行资料。